⚡
Présentation
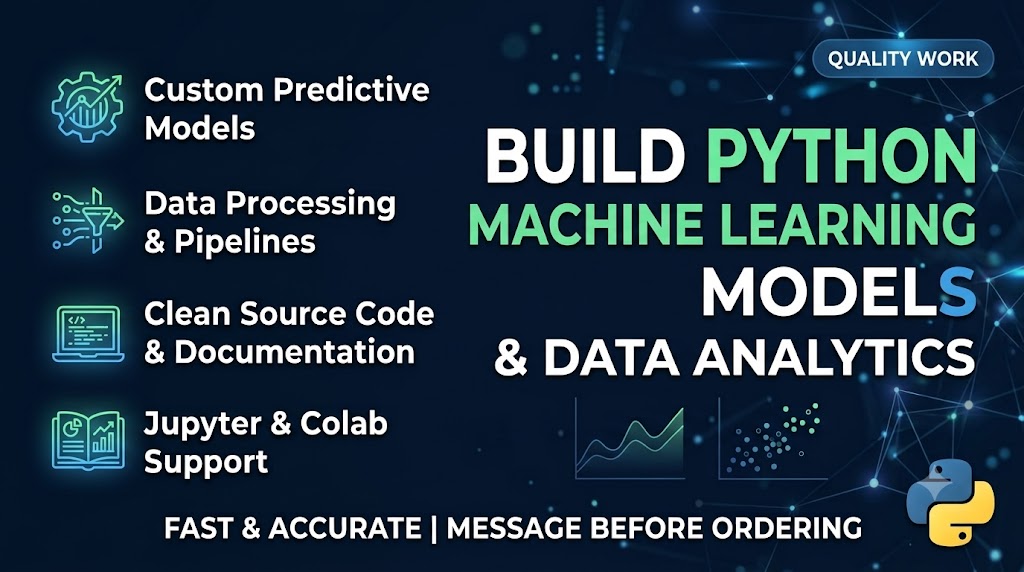
Je propose des solutions de bout en bout en apprentissage automatique, apprentissage par renforcement et analyse de données en Python pour aider les entreprises et les chercheurs à transformer des données complexes en systèmes intelligents et performants.
Ce que je propose :
• Modèles d’apprentissage automatique personnalisés : modèles supervisés et non supervisés pour la classification, la régression, le clustering et la détection d’anomalies.
• Apprentissage par renforcement (RL) : conception d’environnements, optimisation des structures de récompense et algorithmes de RL pour les tâches de prise de décision séquentielle et de contrôle.
• Analyses prédictives et pipelines : modélisation prédictive de bout en bout, optimisation de réseaux non convexes et workflows automatisés de traitement des données.
• Prétraitement des données et ingénierie des caractéristiques : nettoyage et transformation des données, ainsi qu’ingénierie des caractéristiques spatiales et tabulaires pour maximiser la précision des modèles.
• Code source et livrables propres : scripts Python structurés et entièrement commentés (.py), notebooks Jupyter ou liens Google Colab avec documentation d’installation.
• Déploiement via API et dans le cloud : assistance pour déployer les modèles et intégrer des points de terminaison prédictifs aux workflows existants.
Pourquoi travailler avec moi ?
• Rigueur technique et code propre : solutions Python modulaires, reproductibles et bien documentées utilisant Scikit-learn, PyTorch, SciPy et Pandas.
• Haute précision et hautes performances : forte attention portée aux métriques d’évaluation, à la minimisation de la perte et à l’optimisation des modèles.
• Confidentialité stricte des données : vos données et les détails de votre projet restent entièrement privés et sécurisés.
N’hésitez pas à m’envoyer les objectifs de votre projet ou les détails de votre jeu de données afin de discuter d’options adaptées !
🖼️
Portfolio
📋
Parcours
🇬🇧Anglais
🕐
Horaires de travail
Lundi
De08h00à18h00
Mardi
De08h00à18h00
Mercredi
De08h00à18h00
Jeudi
De08h00à18h00
Vendredi
De08h00à18h00
Samedi
Fermé
Dimanche ▪ Aujourd’hui
Fermé
⭐
Avis
Merci de vous connecter en tant que client pour pouvoir donner votre avis
💬
Aucun avis pour le moment.
Soyez le premier à partager votre expérience avec ce professionnel.