⚡
Présentation
Je suis ingénieur senior full-stack en IA et apprentissage automatique, avec plus de 10 ans d’expérience dans l’architecture, le développement et le déploiement d’applications web, mobiles et cloud alimentées par l’intelligence artificielle et conçues pour évoluer. Mon expertise couvre l’ensemble de la pile technologique, de l’ingénierie frontend et backend à l’entraînement des modèles d’apprentissage automatique, l’optimisation de l’inférence et l’intégration de bout en bout de systèmes intelligents dans des environnements de production.
Je me spécialise dans la création de solutions d’IA full-stack qui associent harmonieusement des frameworks web modernes tels que React, Next.js, Node.js, FastAPI et Django, ainsi que des technologies mobiles multiplateformes comme Flutter, React Native et Ionic, à des frameworks avancés d’IA et d’apprentissage automatique tels que PyTorch et TensorFlow. Mon objectif est de fournir des systèmes robustes et performants, capables de prendre des décisions en temps réel, d’effectuer des analyses visuelles et de proposer des expériences utilisateur interactives.
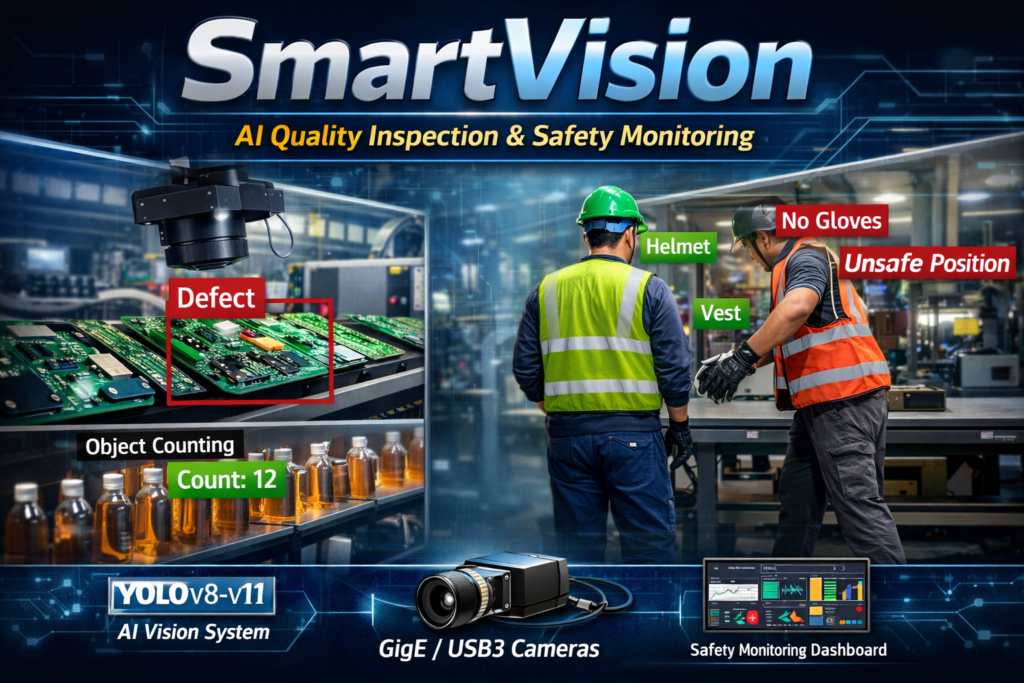
Dans le domaine de l’IA, je possède une vaste expérience en vision par ordinateur, grands modèles de langage, génération d’images et de vidéos, ainsi qu’en IA vocale. Je conçois et entraîne des modèles personnalisés avec des outils tels que Roboflow, YOLO, Detectron2, Stable Diffusion, ComfyUI, Invoke AI, Runway et LangChain, puis je les intègre dans des applications déployées dans le cloud. En parallèle, je développe des systèmes avancés d’IA vocale et de traitement de la parole avec OpenAI Whisper, ElevenLabs, Deepgram et Twilio, afin de permettre la synthèse vocale en temps réel, la transcription et des agents conversationnels utilisant des architectures WebRTC et WebSocket.
Mon expertise backend comprend la création de microservices d’IA cloud-native sur AWS, Azure et GCP, leur déploiement avec Docker et Kubernetes, ainsi que la mise en œuvre de pipelines RAG et de bases de données vectorielles comme Pinecone et FAISS, avec l’orchestration LangChain pour une inférence d’IA évolutive. J’accorde une grande importance aux performances des systèmes, à l’observabilité et aux architectures à faible latence pour toutes les charges de travail d’IA.
Grâce à de solides bases en ingénierie logicielle, en apprentissage automatique et en conception d’interfaces intelligentes, je fournis des systèmes d’IA prêts pour la production qui réunissent la vision, le langage et la voix au sein d’expériences numériques cohérentes.
🖼️
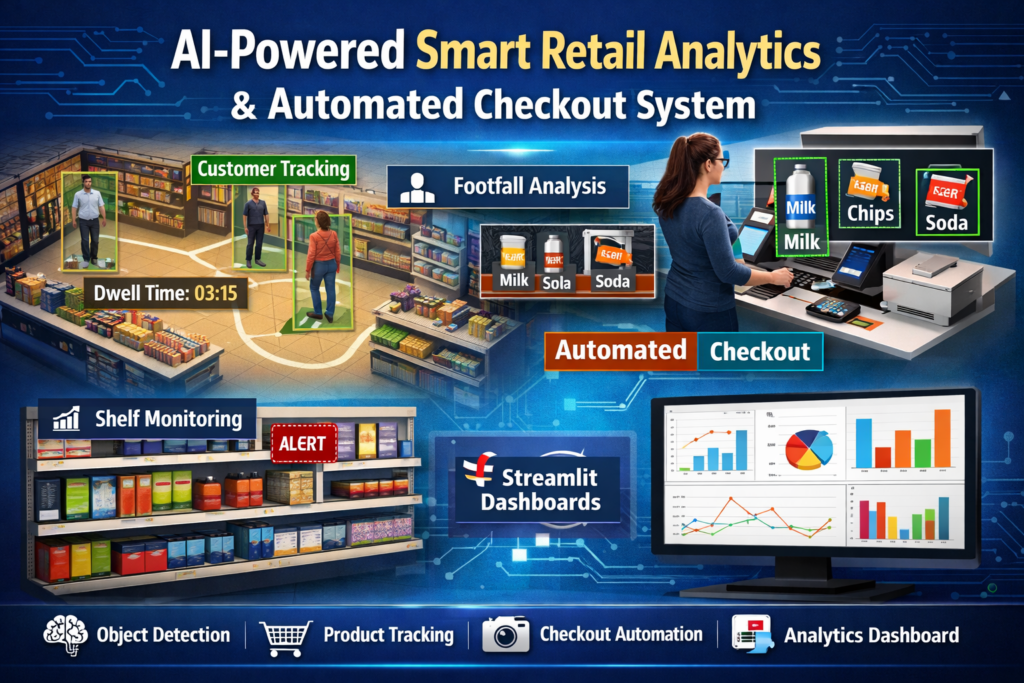
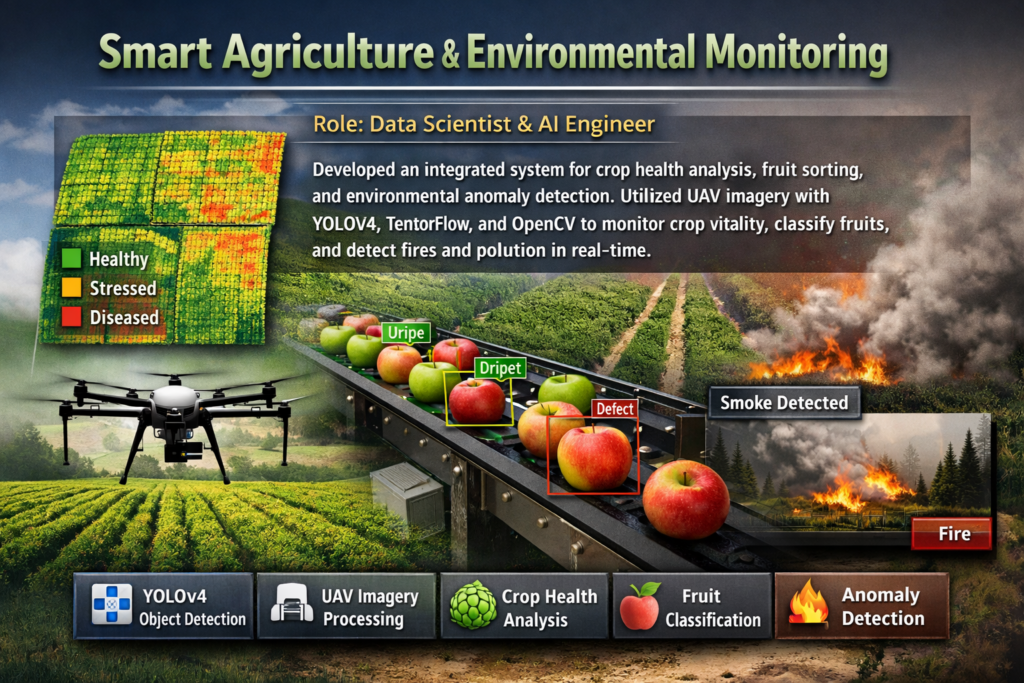
Portfolio
🕐
Horaires de travail
Lundi
De08h00à18h00
Mardi ▪ Aujourd’hui
De08h00à18h00
Mercredi
De08h00à18h00
Jeudi
De08h00à18h00
Vendredi
De08h00à18h00
Samedi
Fermé
Dimanche
Fermé
⭐
Avis
Merci de vous connecter en tant que client pour pouvoir donner votre avis
💬
Aucun avis pour le moment.
Soyez le premier à partager votre expérience avec ce professionnel.